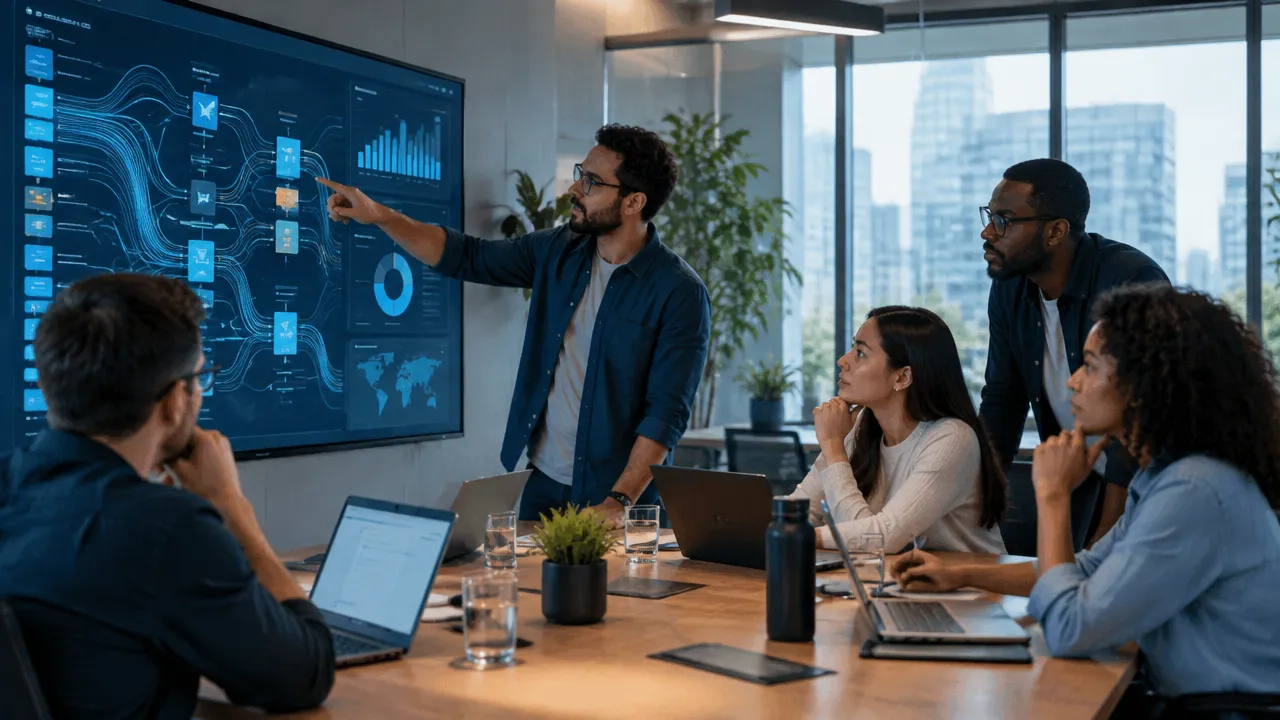
Operações de dados, conhecidas como DataOps, combinam processos, automação e colaboração para tornar os dados mais confiáveis e disponíveis para quem precisa decidir. A abordagem é útil para empresas que trabalham com várias fontes e querem reduzir atrasos, retrabalho e inconsistências, sem transformar cada demanda analítica em um projeto isolado. O ponto central não é comprar uma ferramenta: é operar o ciclo dos dados com responsabilidades e critérios claros.
O essencial sobre operações de dados
- Organize o fluxo completo, da origem dos dados ao uso em relatórios, análises ou processos comerciais.
- Automatize verificações repetitivas, mas mantenha responsáveis definidos para resolver problemas.
- Monitore qualidade, atualizações e falhas para identificar impactos antes que se espalhem.
- Una as equipes técnicas e de negócio em torno de definições compartilhadas.
- Meça o resultado pelo valor e pela confiabilidade dos dados, não apenas pelo volume processado.
DataOps organiza o trabalho em torno de dados confiáveis
DataOps é uma abordagem operacional para desenvolver, manter e melhorar fluxos de dados de forma colaborativa. Ela combina práticas de engenharia, automação, controle de mudanças, testes e monitoramento, com participação das áreas que consomem os dados. A definição de DataOps da IBM também destaca essa conexão entre processos, tecnologia e equipes.
Na prática, isso significa tratar um conjunto de dados como um produto mantido ao longo do tempo. É preciso saber de onde vem, quem responde por ele, quando deve ser atualizado, quais verificações precisa passar e quais decisões pretende apoiar. Sem esses acordos, uma rotina automatizada pode entregar dados rapidamente, mas continuar entregando informação inconsistente.
Por isso, a abordagem não se resume a instalar uma plataforma de orquestração ou montar painéis. Ferramentas ajudam a executar o processo; padrões, responsabilidades e retorno das pessoas usuárias fazem com que ele funcione.
O fluxo conecta fontes, verificações e consumidores
Um processo bem definido acompanha os dados desde a entrada até o consumo e prevê o que fazer quando uma etapa falha. O desenho varia por empresa, mas costuma reunir as seguintes atividades:
- Ingestão: reunir dados de sistemas internos, parceiros ou fontes externas, registrando sua origem e frequência.
- Preparação: padronizar formatos, corrigir inconsistências tratáveis e combinar informações com regras documentadas.
- Validação: aplicar testes de preenchimento, formato, unicidade, coerência e atualização, de acordo com o uso esperado.
- Disponibilização: publicar conjuntos de dados em ambientes e formatos adequados para análise ou operação.
- Monitoramento: acompanhar atrasos, falhas, mudanças inesperadas e relatos dos usuários, encaminhando incidentes a responsáveis.
O ciclo se aperfeiçoa quando o retorno dos consumidores volta para quem mantém o fluxo. Se uma equipe comercial encontra registros duplicados ou desatualizados, por exemplo, a informação deve gerar uma investigação da origem e uma correção na regra, não apenas uma edição manual pontual.
Automação funciona melhor com critérios de qualidade claros
Automatizar tarefas repetitivas acelera a entrega, mas não define por si só o que é um dado aceitável. Antes de criar testes, a equipe precisa estabelecer requisitos que façam sentido para o consumidor: quais campos são obrigatórios, que frequência de atualização é necessária e que variações são válidas.
Esses requisitos podem ser convertidos em verificações automáticas executadas na entrada ou após transformações importantes. Uma alteração que cause aumento inesperado de registros sem identificador, por exemplo, pode gerar um alerta ou impedir a publicação até que alguém avalie o impacto. O procedimento precisa distinguir entre uma falha crítica e uma exceção legítima.
Também é importante registrar mudanças nos códigos e nas regras de transformação, testar alterações antes de aplicá-las e manter uma forma controlada de reverter uma implantação problemática. A visão da Databricks sobre DataOps relaciona a prática à entrega e ao gerenciamento contínuos de dados. A automação deve tornar o processo repetível e observável, não ocultar decisões.
DataOps, DevOps e MLOps resolvem desafios relacionados, mas distintos
As três abordagens podem compartilhar automação e colaboração, mas seus objetos de trabalho não são iguais. Separar seus objetivos ajuda a evitar que a empresa confunda a operação dos dados com a entrega de software ou com a manutenção de modelos de inteligência artificial.
| Abordagem | Foco principal | Exemplos de trabalho |
|---|---|---|
| DevOps | Entrega e operação de software | Integração de código, testes e implantação de aplicações |
| DataOps | Fluxos e produtos de dados | Ingestão, transformação, validação e monitoramento |
| MLOps | Ciclo de vida de modelos de aprendizado de máquina | Preparação de dados de treino, implantação e acompanhamento de modelos |
Uma organização pode usar as três práticas em conjunto. Por exemplo, um produto analítico pode depender de pipelines organizados por DataOps, ser entregue por processos de DevOps e incluir modelos acompanhados por MLOps. O desenho adequado depende da arquitetura e do problema, não da adoção de todos os termos ao mesmo tempo.
A implantação deve começar por um fluxo importante
Uma adoção gradual costuma ser mais sustentável do que tentar padronizar todos os dados da empresa de uma só vez. Escolha um fluxo que afete uma decisão relevante e use-o para estabelecer um método que possa ser repetido.
- Mapeie o fluxo: documente fontes, transformações, responsáveis, consumidores e pontos de falha.
- Defina o resultado esperado: determine que decisão ou processo depende dos dados e com que prazo.
- Combine regras de qualidade: registre critérios verificáveis com as áreas consumidoras.
- Automatize etapas previsíveis: priorize testes e tarefas manuais recorrentes, mantendo uma rota para exceções.
- Implemente monitoramento e resposta: defina alertas, níveis de prioridade e responsáveis por cada tipo de incidente.
- Revise e amplie: use falhas e feedback para ajustar o processo antes de levá-lo a outros fluxos.
Esse primeiro caso também deve esclarecer quem pode alterar regras, como mudanças são comunicadas e como se identifica a versão utilizada em uma análise. Essas decisões evitam que diferentes equipes produzam resultados incompatíveis a partir de dados aparentemente iguais.
Indicadores devem ligar a saúde técnica ao uso no negócio
Uma operação eficiente acompanha tanto o funcionamento dos pipelines quanto a experiência de quem usa os dados. Uma lista inicial de indicadores pode incluir:
- Atualização: se os dados chegam dentro da frequência acordada.
- Qualidade: proporção de registros que atende aos critérios definidos para o fluxo.
- Falhas: frequência de interrupções, tempo até detecção e tempo até resolução.
- Retrabalho: quantidade de correções manuais ou incidentes recorrentes.
- Utilidade: se os dados estão sendo usados na análise ou processo que motivou sua disponibilização.
Os indicadores precisam de contexto. Uma falha rara que impede uma decisão crítica pode merecer mais atenção do que erros frequentes em um relatório de baixo impacto. Defina metas a partir das necessidades reais dos consumidores e reveja-as quando essas necessidades mudarem.
Dados organizados tornam a prospecção mais consistente
Em operações comerciais, dados externos e internos podem ajudar a identificar empresas com perfil adequado, segmentar mercados e orientar prioridades de contato. Para isso, é importante manter critérios de seleção explícitos, verificar a atualidade das informações e integrar os resultados ao processo utilizado pelas equipes. A tecnologia pode apoiar a rotina, mas a empresa ainda precisa definir o perfil de cliente e as ações decorrentes.
A Connect Smart Data reúne dados de mercado e informações internas para apoiar análises comerciais, segmentação e prospecção. Seus recursos incluem informações empresariais validadas, filtros e segmentações, além de integração com CRMs e sistemas internos. Esses recursos podem compor o fluxo de dados de uma operação comercial, mas não substituem a definição de governança, responsáveis e critérios de qualidade da própria organização.
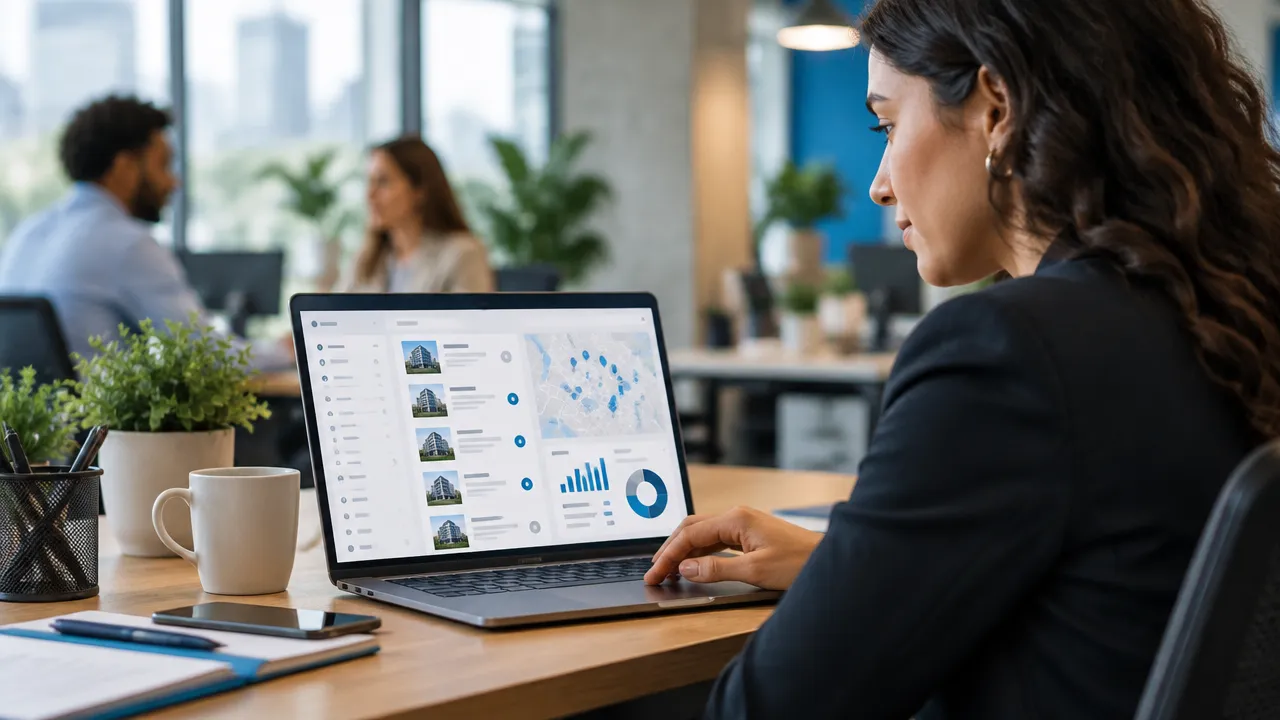
Um exemplo prático é revisar como uma lista de empresas é preparada antes de chegar ao time de vendas. A equipe pode acordar quais atributos são necessários, como segmentar os potenciais clientes, com que frequência atualizar os registros e como devolver informações de contato ou descarte para análises futuras. Assim, o fluxo conecta qualidade de dados e execução comercial sem presumir que uma lista, sozinha, garante conversão.
Erros comuns surgem quando a automação vem antes dos acordos
Uma implementação pode falhar mesmo com tecnologia adequada quando as equipes não compartilham definições ou não sabem quem deve agir diante de um problema. Antes de ampliar os fluxos, verifique se o processo evita estes pontos:
- Automatizar sem conhecer a origem: documente fontes e limitações para interpretar mudanças corretamente.
- Usar uma definição diferente por área: alinhe conceitos como cliente ativo, lead válido ou atualização recente.
- Monitorar apenas a infraestrutura: inclua verificações de qualidade e feedback dos consumidores.
- Tratar todo alerta como crítico: classifique incidentes conforme o impacto e a urgência.
- Expandir antes de aprender: corrija as causas recorrentes no primeiro fluxo antes de replicar o modelo.
O melhor sinal de maturidade não é ter o maior número de ferramentas ou alertas. É conseguir explicar de onde veio um dado, para que serve, como sua qualidade é verificada e quem resolve uma falha que afeta uma decisão.
Perguntas frequentes
O que significa DataOps?
DataOps, ou operações de dados, é uma forma de organizar pessoas, processos e tecnologia para entregar dados confiáveis com rapidez. A abordagem aplica automação, testes, colaboração e monitoramento ao ciclo de vida dos dados, da coleta ao uso em análises e decisões comerciais.
Quais são os principais benefícios do DataOps?
A abordagem reduz retrabalho e falhas ao automatizar validações, padronizar fluxos e tornar problemas mais fáceis de detectar. Também aproxima equipes técnicas e áreas de negócio, o que ajuda a disponibilizar dados úteis no momento certo e a acompanhar seu impacto nas decisões.
Qual é a diferença entre DataOps e DevOps?
DevOps organiza a colaboração e a entrega de software entre desenvolvimento e operações de TI. DataOps adapta princípios semelhantes ao ciclo de dados, incluindo ingestão, transformação, validação e disponibilização. As duas práticas podem compartilhar automação e controle de mudanças, mas atendem a produtos e fluxos diferentes.
Qual é a diferença entre DataOps e MLOps?
DataOps cuida dos fluxos e produtos de dados usados por diferentes áreas, enquanto MLOps se concentra no ciclo de vida de modelos de aprendizado de máquina. MLOps pode depender de uma base DataOps bem organizada, mas acrescenta tarefas como versionamento, implantação e monitoramento de modelos.
Como começar a implementar DataOps?
Comece escolhendo um fluxo de dados importante e identificando seus responsáveis, usuários, etapas e falhas recorrentes. Depois, defina critérios de qualidade, automatize testes e monitore atualizações e erros. Amplie a prática gradualmente, avaliando tanto a confiabilidade técnica quanto o uso dos dados nas decisões do negócio.