Um pipeline de dados é uma sequência automatizada que leva informações de suas fontes até um destino onde possam ser analisadas ou usadas em processos de negócio. Para equipes comerciais, seu valor não está apenas em mover registros, mas em tornar dados de mercado e clientes consistentes, atualizados e acionáveis. A seguir, veja suas etapas, tipos, um exemplo de prospecção e como planejar um fluxo confiável.
O essencial é transformar dados dispersos em informação utilizável
- O fluxo conecta fontes, regras de tratamento e destinos, como um painel analítico ou um CRM.
- Validação, padronização e deduplicação precisam fazer parte do desenho, não ser correções improvisadas.
- A frequência de atualização deve refletir a decisão que o dado apoia, não uma preferência tecnológica.
- Monitoramento e responsáveis definidos ajudam a detectar registros incompletos antes que afetem a operação.
- Na prospecção, o ciclo melhora quando os resultados das ações comerciais retornam ao processo de análise.
Um pipeline de dados é um fluxo com origem, tratamento e destino
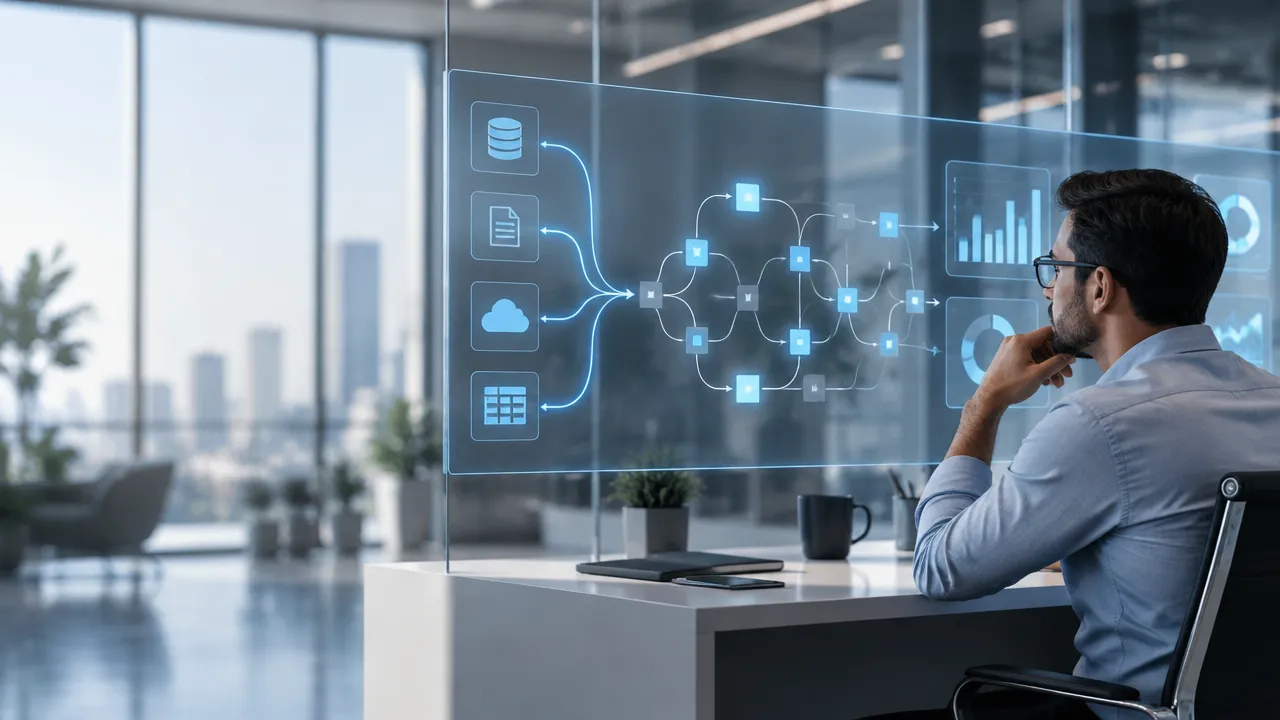
Em termos práticos, esse fluxo reúne dados de uma ou mais fontes, aplica operações e regras e entrega o resultado a um sistema de consumo. A origem pode ser um banco de dados, um arquivo, uma API ou um sistema interno. O destino pode ser um data lake, um armazém analítico, um painel ou uma plataforma comercial.
O pipeline pode executar em lote, em horários predefinidos, ou processar eventos continuamente. Em ambos os casos, não é apenas uma conexão entre sistemas: inclui a lógica que define quais dados entram, como são ajustados e o que fazer quando há erro. A explicação da AWS sobre pipelines de dados também apresenta esse conceito como o movimento e processamento de dados entre etapas e sistemas.
Uma distinção ajuda a evitar confusões: pipeline de dados não é sinônimo de pipeline de vendas. O primeiro organiza informações; o segundo representa as etapas de uma oportunidade comercial, como qualificação e negociação. Eles se complementam quando dados confiáveis ajudam a equipe a decidir quais contas priorizar.
As etapas precisam preservar o significado dos dados
Um bom desenho acompanha os dados desde a origem até o uso final. A sequência exata depende da finalidade, mas normalmente inclui coleta, validação, transformação, armazenamento ou entrega e monitoramento.
- Coleta: extrair ou receber informações das fontes autorizadas, identificando sua origem e frequência.
- Validação: verificar campos obrigatórios, formatos, duplicidades e consistência básica.
- Transformação: padronizar nomes, datas e categorias, além de combinar registros quando necessário.
- Entrega: carregar os dados tratados no ambiente onde serão consultados ou usados.
- Monitoramento: acompanhar falhas, atrasos e alterações inesperadas na qualidade ou no volume.
Por exemplo, datas podem chegar em formatos diferentes e nomes empresariais podem conter abreviações. Sem tratamento, filtros e comparações podem produzir resultados enganosos. Cada etapa deve manter rastreável a origem dos registros e as regras aplicadas, para que analistas consigam investigar discrepâncias sem reconstruir todo o processo do zero.
Um exemplo comercial mostra onde o fluxo gera valor
Imagine uma empresa que deseja encontrar novos clientes B2B com características semelhantes às de sua carteira atual. O processo pode reunir a base interna de clientes e informações externas sobre empresas, padronizar identificadores, remover duplicidades e organizar atributos relevantes para segmentação.
Depois, analistas definem critérios para identificar empresas compatíveis com o perfil desejado. Os segmentos aprovados podem alimentar uma ferramenta de inteligência comercial ou um CRM, onde a equipe prioriza contas e registra contatos, oportunidades e resultados. Esses registros de execução podem voltar à análise, permitindo comparar quais perfis geraram conversas, propostas ou vendas.
Esse ciclo evita tratar a prospecção como uma lista estática. Ainda assim, o resultado depende das definições: uma correspondência incompleta entre registros pode criar falsos duplicados, e um critério mal escolhido pode excluir empresas relevantes. Por isso, vale testar o fluxo com uma amostra e revisar os resultados com as pessoas que conhecem o mercado e a operação comercial.
O método de processamento depende do prazo de uso
O modo de execução deve atender à velocidade exigida pelo negócio. Atualizar uma lista de prospecção uma vez por dia pode bastar para planejamento semanal; uma operação que reage a eventos imediatos pode exigir tratamento contínuo. Processamento mais rápido não é automaticamente melhor se aumenta custo e complexidade sem mudar a decisão.
| Abordagem | Como funciona | Quando pode fazer sentido |
|---|---|---|
| Em lote | Processa conjuntos de registros em intervalos definidos. | Relatórios periódicos, atualização diária de bases e cargas programadas. |
| Em fluxo | Trata eventos conforme chegam ou em intervalos curtos. | Alertas, acompanhamento de eventos recentes e processos sensíveis ao tempo. |
Também é comum distinguir ETL e ELT. No ETL, os dados são extraídos, transformados e depois carregados no destino. No ELT, são carregados primeiro e transformados no ambiente de destino. A escolha depende dos sistemas disponíveis, das regras de acesso, do volume e de onde a organização consegue executar e auditar as transformações com segurança.
Qualidade, rastreabilidade e alertas evitam falhas silenciosas
Um fluxo que termina sem erros técnicos ainda pode entregar dados ruins. Registros incompletos, campos trocados, duplicidades e atrasos podem comprometer análises e decisões sem interromper a execução. Por isso, defina verificações relacionadas ao uso: campos essenciais preenchidos, identificadores únicos quando aplicável e volumes dentro de limites esperados.
Inclua também controles operacionais claros. Cada etapa deve ter um responsável, um procedimento para falhas e uma forma de reprocessar os dados afetados. Registre quando a carga ocorreu, quantos registros foram recebidos e rejeitados e quais regras de transformação foram aplicadas. Se a origem mudar a estrutura, um alerta deve sinalizar a alteração antes que ela se propague silenciosamente.
Em contexto comercial, a qualidade não se resume à completude técnica. É importante revisar se os campos representam o conceito que a equipe precisa, se a atualização atende ao ciclo de vendas e se os resultados podem ser usados de acordo com as regras internas da empresa. A validação com usuários evita automatizar uma interpretação incorreta em grande escala.
Como planejar um fluxo antes de escolher ferramentas
Comece pela decisão que o pipeline precisa apoiar. A ferramenta vem depois: sem um destino, uma frequência e critérios de sucesso, é fácil automatizar uma transferência que não melhora o trabalho de ninguém.
- Defina o uso: que decisão, análise ou tarefa ficará melhor com os dados?
- Mapeie as fontes: quem mantém cada origem, que campos oferece e com que frequência muda?
- Especifique as regras: o que será validado, padronizado, combinado ou descartado?
- Escolha destino e frequência: entregue no sistema apropriado, no ritmo necessário à operação.
- Planeje exceções: determine alertas, responsáveis, registros de auditoria e reprocessamento.
- Meça o resultado: acompanhe qualidade, disponibilidade e impacto no processo apoiado.
Um piloto com poucas fontes e um caso de uso delimitado permite identificar problemas de definição antes de ampliar o fluxo. Estabeleça uma linha de base e compare, por exemplo, a proporção de registros utilizáveis ou o tempo para preparar uma segmentação. Não presuma que o pipeline causou uma mudança comercial apenas porque a métrica melhorou: considere outros fatores e valide com a equipe.
Como a Connect Smart Data se relaciona com esse processo
A Connect Smart Data descreve uma plataforma que reúne dados externos e internos de empresas para transformá-los em análises de mercado e apoiar a geração de negócios. Entre os usos apresentados estão análise de dados, inteligência comercial, planejamento de negócios e integração com CRM, ERP e data lake.
Na prática, esse tipo de solução pode compor etapas de um processo de dados comercial: combinar informações de mercado com a carteira existente, validar registros, segmentar empresas e levar resultados a sistemas usados pela equipe. A empresa também descreve dados públicos provenientes de mais de 80 fontes, informações internas e integração de dados com sistemas comerciais. Os recursos adequados dependem do caso de uso e da configuração adotada.
Para avaliar aderência, pergunte como são tratadas atualizações, validações, integrações, campos personalizados e retorno dos resultados da execução comercial. A plataforma de inteligência comercial da Connect Smart Data é apresentada como parte de um ciclo contínuo de aprimoramento por meio de dados qualificados e integrações. O critério decisivo é verificar se o fluxo apoia uma decisão concreta e se a qualidade pode ser acompanhada.
Perguntas frequentes
O que é um pipeline de dados?
Um pipeline de dados é um fluxo organizado de etapas que coleta dados de uma ou mais fontes, transforma-os conforme regras definidas e os entrega a um destino para análise ou uso operacional. Ele pode rodar em horários programados ou continuamente, e deve incluir controles para detectar falhas e problemas de qualidade.
Quais são as etapas de um pipeline de dados?
As etapas mais comuns são identificar e coletar dados, validar e padronizar os registros, transformar ou combinar informações, carregar o resultado em um destino e monitorar a execução. A ordem e as operações variam conforme a finalidade. Por exemplo, uma análise comercial pode exigir deduplicação e enriquecimento antes de atualizar o CRM.
Como fazer um pipeline de dados?
Para criar um pipeline, defina primeiro a decisão ou processo que ele precisa apoiar e o destino dos dados. Depois, mapeie as fontes, estabeleça regras de transformação e qualidade, escolha a frequência de atualização, implemente alertas e teste exceções. Comece com um fluxo pequeno e valide os resultados com quem usará os dados.
Qual é a diferença entre pipeline de dados e pipeline de CRM?
Um pipeline de dados move e prepara informações entre sistemas; um pipeline de vendas ou CRM representa as etapas pelas quais uma oportunidade comercial passa, como qualificação, proposta e fechamento. Eles podem se conectar: dados atualizados no CRM ajudam a equipe a priorizar contatos, mas os dois pipelines têm funções diferentes.
Qual é a diferença entre processamento em lote e em tempo real?
O processamento em lote reúne registros e os processa em horários definidos, como uma atualização noturna de empresas e contatos. O processamento em fluxo trata eventos à medida que chegam, quando a operação precisa reagir rapidamente. A escolha depende da urgência, do volume, do custo e da capacidade dos sistemas de origem e destino.